English · PDF 400
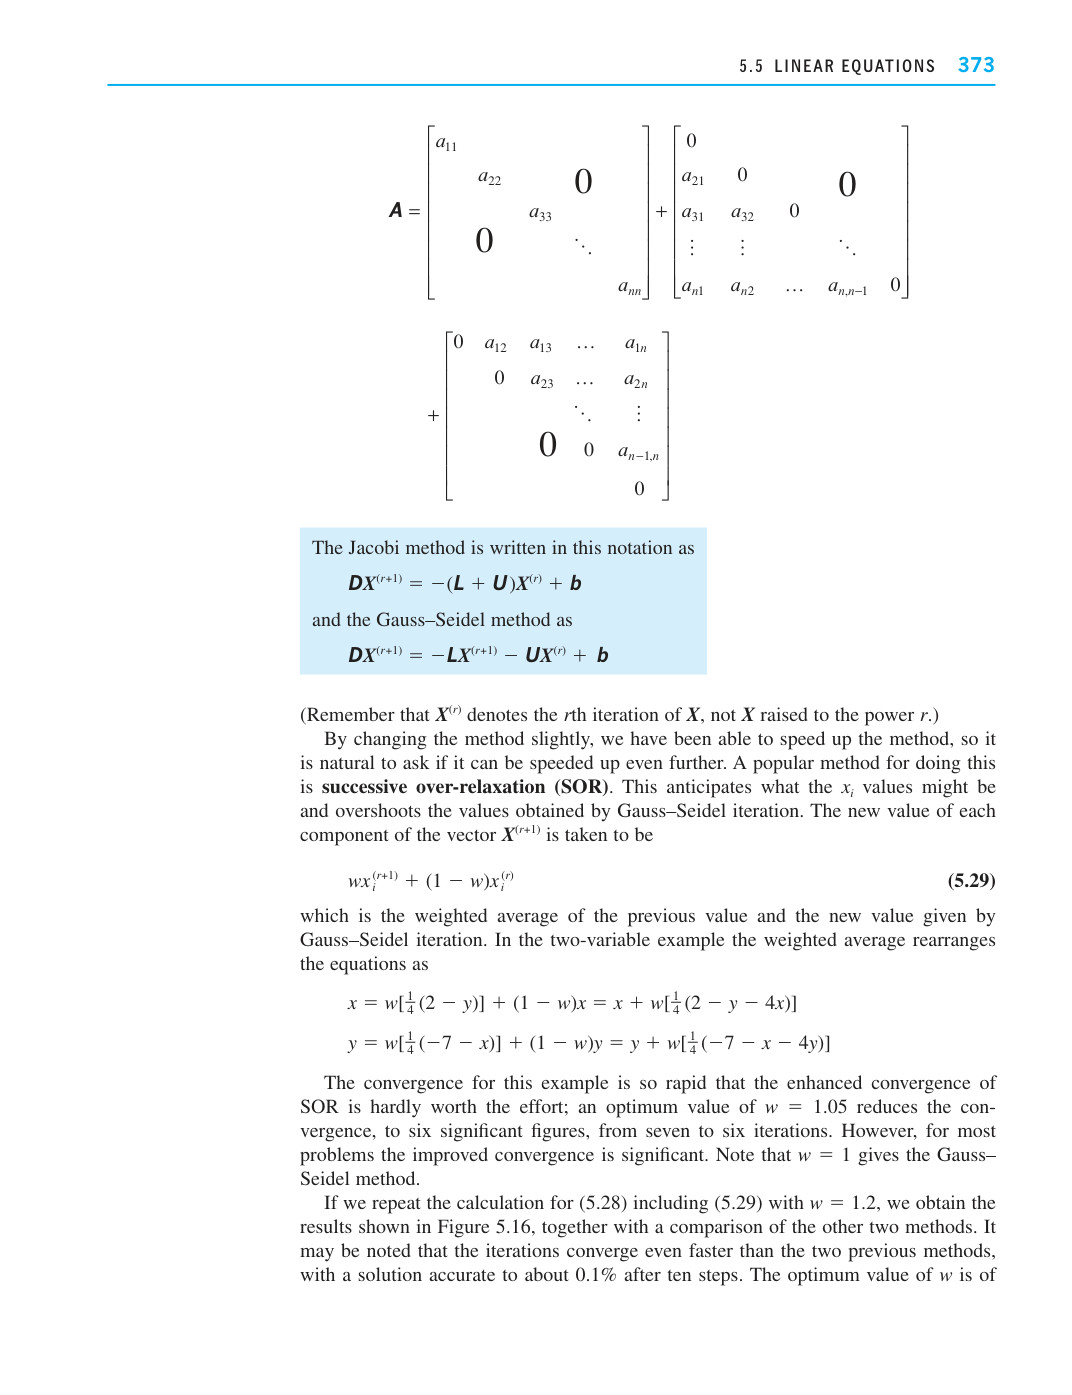
$$\mathbf{A} = \begin{bmatrix} a_{11} & & & & & & & & 0 \ & a_{22} & & & & & & & 0 \ & & a_{33} & & & & & & 0 \ & & & \ddots & & & & & 0 \ & & & & a_{nn} & & & & 0 \end{bmatrix} + \begin{bmatrix} 0 & & & & & & & & 0 \ a_{21} & 0 & & & & & & & 0 \ a_{31} & a_{32} & 0 & & & & & & 0 \ \vdots & \vdots & \vdots & & & & & & 0 \ a_{n1} & a_{n2} & \dots & & & & & & a_{n,n-1} & 0 \end{bmatrix}$$
$$+ \begin{bmatrix} 0 & a_{12} & a_{13} & \dots & a_$$
雅可比法在此记号下写为
$$\mathbf{D}\mathbf{X}^{(r+1)} = -(\mathbf{L} + \mathbf{U})\mathbf{X}^{(r)} + \mathbf{b}$$
而高斯–赛德尔法则写为
$$\mathbf{D}\mathbf{X}^{(r+1)} = -\mathbf{L}\mathbf{X}^{(r+1)} - \mathbf{U}\mathbf{X}^{(r)} + \mathbf{b}$$
(记住 X(r) 表示 X 的第 r 次迭代,而不是 X 的 r 次幂。)
通过稍微改变方法,我们能够加快方法的收敛速度,因此自然会问是否还能进一步加速。一种常用的方法是逐次超松弛法(SOR)。该方法预先估计 xi 值可能的大小,并超出高斯–赛德尔迭代所得的值。向量 X(r+1) 的每个分量的新值取为
$$wx_i^{(r+1)} + (1 - w)x_i^{(r)} \quad (5.29)$$
即前一个值与高斯–赛德尔迭代给出的新值的加权平均。在双变量例子中,加权平均将方程组重排为
$$x = w[\frac{1}{4}(2 - y)] + (1 - w)x = x + w[\frac{1}{4}(2 - y - 4x)]$$
$$y = w[\frac{1}{4}(-7 - x)] + (1 - w)y = y + w[\frac{1}{4}(-7 - x - 4y)]$$
此例的收敛速度非常快,以至于 SOR 增强的收敛效果几乎不值得费这个功夫;一个最优值 $w = 1.05$ 将收敛到六位有效数字所需的迭代次数从七次减少到六次。然而,对于大多数问题,收敛性的改进是显著的。注意 $w = 1$ 给出高斯–赛德尔法。
如果我们对 (5.28) 连同 (5.29) 用 $w = 1.2$ 重复计算,就得到图 5.16 所示的结果,并与其他两种方法进行了比较。可以注意到,该迭代的收敛速度甚至比前两种方法更快,十步之后解的精度约为 0.1%。最优值 $w$ 为