English · PDF 1035
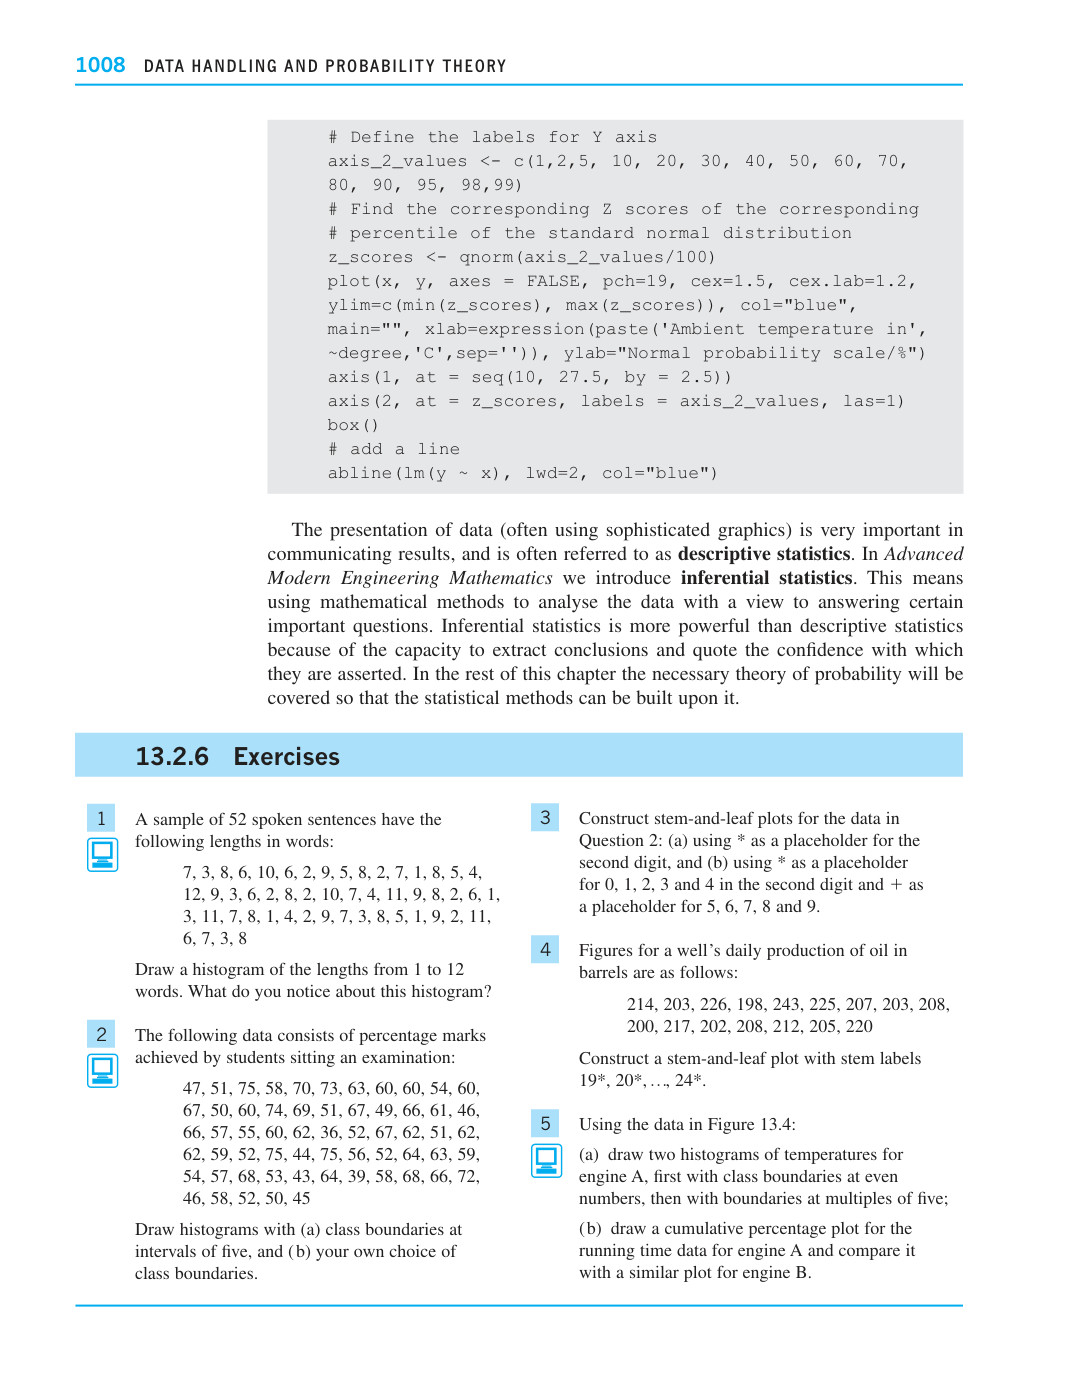
1 52 个口语句子样本的单词长度如下:
7, 3, 8, 6, 10, 6, 2, 9, 5, 8, 2, 7, 1, 8, 5, 4, 12, 9, 3, 6, 2, 8, 2, 10, 7, 4, 11, 9, 8, 2, 6, 1, 3, 11, 7, 8, 1, 4, 2, 9, 7, 3, 8, 5, 1, 9, 2, 11, 6, 7, 3, 8
绘制长度从 1 到 12 个单词的直方图。你从这个直方图中注意到了什么?
2 以下数据是学生参加考试所得的百分制分数:
47, 51, 75, 58, 70, 73, 63, 60, 60, 54, 60, 67, 50, 60, 74, 69, 51, 67, 49, 66, 61, 46, 66, 57, 55, 60, 62, 36, 52, 67, 62, 51, 62, 62, 59, 52, 75, 44, 75, 56, 52, 64, 63, 59, 54, 57, 68, 53, 43, 64, 39, 58, 68, 66, 72, 46, 58, 52, 50, 45
绘制直方图:(a) 组界以 5 为间隔;(b) 自行选择组界。
3 为第 2 题的数据构建茎叶图:(a) 用 * 作为第二位数字的占位符;(b) 用 * 作为第二位数字中 0、1、2、3、4 的占位符,用 + 作为 5、6、7、8、9 的占位符。
4 某油井每日石油产量(以桶计)的数据如下:
214, 203, 226, 198, 243, 225, 207, 203, 208, 200, 217, 202, 208, 212, 205, 220
构建一个茎叶图,茎标签为 19*、20*、...、24*。
5 利用图 13.4 中的数据:

(a) 为发动机 A 的温度绘制两个直方图,第一个组界取偶数,第二个组界取 5 的倍数;
(b) 为发动机 A 的运行时间数据绘制累积百分比图,并将其与发动机 B 的类似图进行比较。
数据的呈现(通常使用复杂的图形)对于交流结果非常重要,通常被称为描述统计。在《高级现代工程数学》中我们介绍了推断统计。这意味着使用数学方法分析数据,以回答某些重要问题。推断统计比描述统计更强大,因为它能够提取结论并给出结论被断言时的置信度。在本章的其余部分将介绍必要的概率理论,以便在其基础上建立统计方法。