English · PDF 1051
连续随机变量 $X$ 可以取某个区间内的任意值 $(v_1, v_2)$ 。如果该区间不是无穷区间,我们定义该随机变量在其外的任何取值处概率为零,从而将定义域扩展到 $(-\infty, +\infty)$ 。典型的例子有人的身高和体重、元件寿命,以及所有以质量、长度、时间、温度、电阻等单位表示的测量量。
一般而言,连续随机变量 $X$ 的行为由概率密度函数 $f_X(x)$ 描述,适用于 $-\infty < x < +\infty$ ,如图 13.20 所示。如下文将解释的, $f_X(x)$ 并不是 $X = x$ 的概率:相反,密度函数必须借助分布函数 $F_X(x)$ 来理解,它(如前所述)度量随机变量的取值小于或等于其自变量的概率 $x$ :
$$F_X(x) = P(X \leq x) \quad (-\infty < x < +\infty)$$
在这种情况下,由于概率没有离散的阶梯,FX(x) 是连续且可微的,其导数称为概率密度函数 fX(x):
$$f_X(x) = \frac{d}{dx}[F_X(x)]$$
密度函数的意义在于,它表示连续随机变量的可能观测值沿实轴的集中程度。这一解释将在下一节中进一步阐明。
例 13.13 某电子元件的寿命(以千小时计)是一个连续随机变量,其概率密度函数为
$$f_X(x) = \begin{cases} \frac{1}{2}e^{-x/2} & (x \geq 0) \ 0 & (x < 0) \end{cases}$$
(这是一个参数为 1 2 的指数分布的例子。)请绘制该分布函数和密度函数的图像。
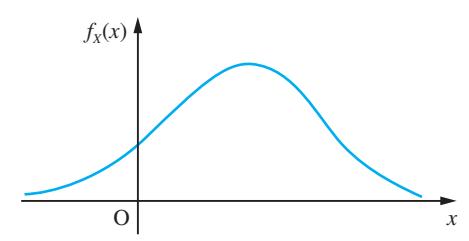
图 13.20 典型的概率密度函数。